إذا كنت قد خضت في تجربة الذكاء الاصطناعي المحلي، فأنت في الواقع لست بحاجة إلى بطاقة RTX ضخمة لتجربة الذكاء الاصطناعي بعد الآن—وكنت أتمنى لو أن أحدهم أخبرني بذلك عاجلاً. لفترة طويلة، افترضت أن تشغيل نماذج الذكاء الاصطناعي المحلية يحتاج إلى وحدة معالجة رسوميات (GPU) قوية، أو رصيد سحابي، أو كليهما.
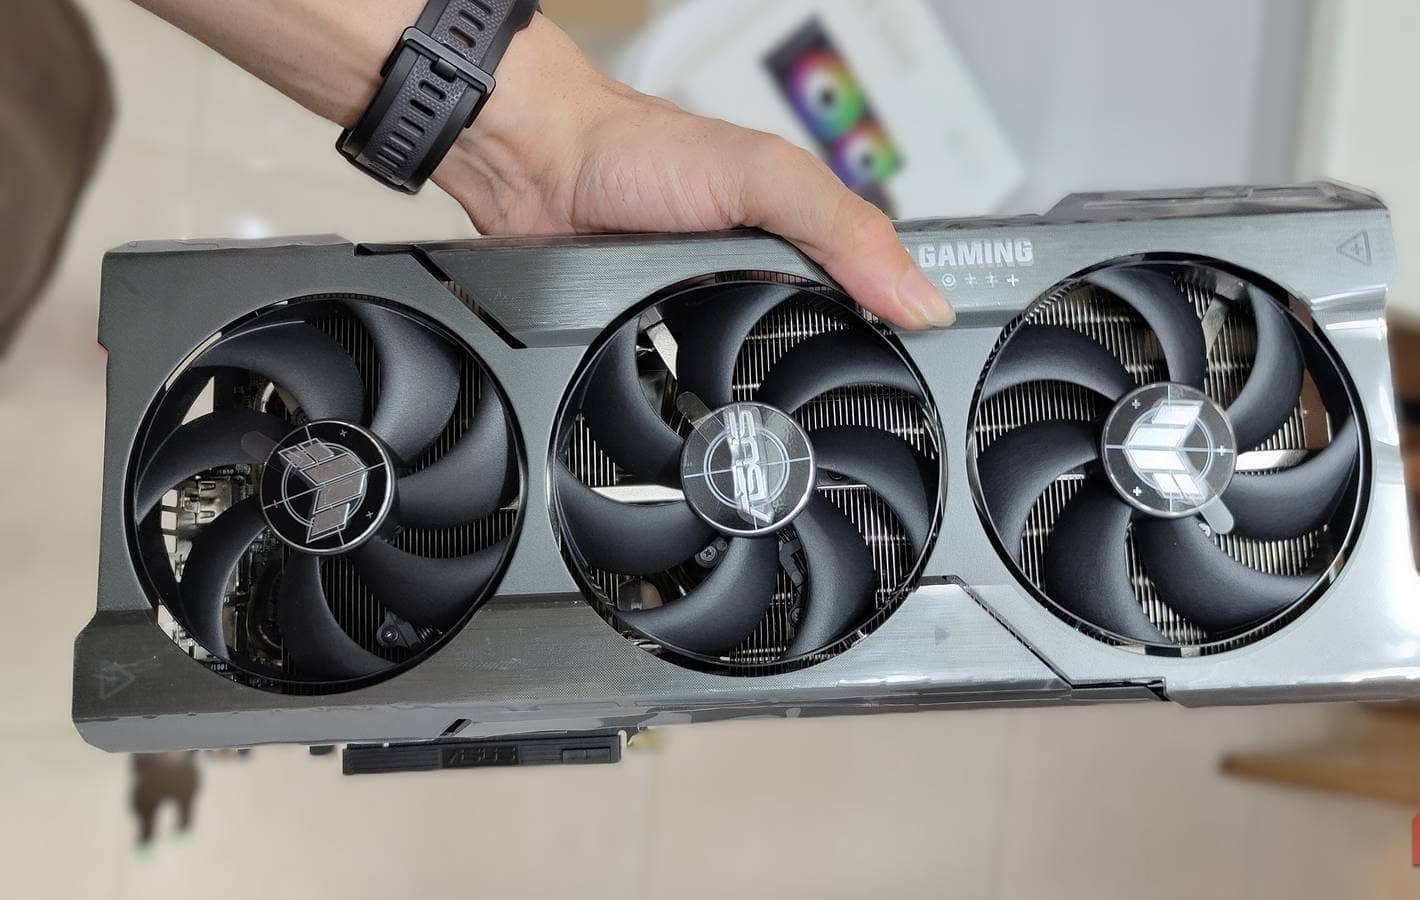
يمكن لأي شخص الاستمتاع بفوائد نموذج لغوي كبير (LLM) محلي باستخدام تطبيقات مجانية، ولكن النماذج مفهوم مختلف تمامًا. ثم اكتشفت النماذج الكمية، وفجأة أصبح جهاز الكمبيوتر المحمول المخصص للألعاب أكثر من كافٍ لتشغيل مساعدين قادرين بشكل مدهش محليًا، بدون اشتراكات وبدون مغادرة البيانات لجهازي.
روابط سريعة
هل أنت حقًا بحاجة إلى وحدة معالجة رسوميات (GPU) عملاقة لتشغيل الذكاء الاصطناعي؟
الفرق بين التدريب والاستدلال
استوعب معظمنا نفس الفكرة: إذا كنت ترغب في تشغيل نماذج الذكاء الاصطناعي الحديثة، فإما أن تدفع مقابل الوصول إلى السحابة أو تنفق أموالًا طائلة على وحدة معالجة رسوميات (GPU) متطورة. هذه الفكرة ليست عشوائية تمامًا—النماذج الكبيرة بدقة كاملة تحتاج إلى الكثير من ذاكرة الوصول العشوائي المرئي (VRAM)—ولكنها قديمة بالنسبة لمعظم حالات الاستخدام العملي.
ما تغير هو أن النماذج أصبحت أصغر حجمًا وأكثر كفاءة دون أن تصبح ألعابًا عديمة الفائدة، وتطورت البرامج المحيطة بها. يمكنك الآن الحصول على نماذج مفيدة حقًا في نطاق 1 مليار إلى 9 مليارات معلمة مصممة للتشغيل على أجهزة الكمبيوتر المحمولة والمكتبية، وليس على أجهزة مراكز البيانات.
يدفع التكميم ذلك إلى أبعد من ذلك عن طريق تقليص حجم هذه النماذج في الذاكرة مع تأثير ضئيل بشكل مدهش على الجودة للمهام اليومية مثل الصياغة والمساعدة في البرمجة وتدوين الملاحظات. عندما تجمع بين بنية أصغر وأكثر ذكاءً مع تكميم جيد، فإن حاجز الدخول ينخفض من محطة عمل للألعاب إلى وحدة معالجة مركزية (CPU) جيدة وذاكرة وصول عشوائي (RAM) كافية. الجهاز الذي تملكه بالفعل يصبح فجأة صندوق ذكاء اصطناعي يعمل بكفاءة تامة.
| النموذج | الحجم (المعلمات) | مناسب لـ | ذاكرة الوصول العشوائي (RAM) النموذجية مع تكميم 4 بت | ملاحظات |
|---|---|---|---|---|
| Phi‑3.5 Mini / Phi‑4 Mini |
ضع في اعتبارك أن هذه الأرقام ليست حدودًا صارمة. إذا كانت لديك ذاكرة وصول عشوائي كافية (16 جيجابايت أو أكثر)، فإن نموذج 3B إلى 7B في 4 بت ممكن تمامًا. ستفتح ذاكرة 32 جيجابايت أو أعلى الباب أمام نماذج 7B إلى 9B دون مشاكل.
ما الذي يفعله التكميم فعليًا
تقليل حجم النموذج دون إتلافه
| النموذج | الحجم (المعلمات) | أفضل الاستخدامات | متطلبات الذاكرة التقريبية | ملاحظات |
|---|---|---|---|---|
| Phi-3 Mini | ~3.8B–4B | دردشة عامة، استنتاج، مقتطفات برمجية | حوالي 4-6 جيجابايت للاستخدام السلس | خط النماذج الصغيرة من Microsoft، مصمم للأجهزة ذات الموارد المحدودة والسيناريوهات غير المتصلة بالإنترنت. |
| Llama 3.2 1B / 3B Instruct | 1B / 3B | مساعدون خفيفو الوزن، أجهزة بذاكرة منخفضة | منخفضة تصل إلى 3-4 جيجابايت لـ 3B (4-bit) | متغيرات تعمل في أي مكان، منتشرة على أجهزة الكمبيوتر المحمولة عبر Ollama و GPT4All. |
| Qwen2.5-7B Instruct | 7B | مساعد عام، مهام منظمة، تحليل خفيف | حوالي 5-8 جيجابايت (4-bit) | يُوصى به كثيرًا كنموذج محلي افتراضي للعمل اليومي. |
| GLM-4-9B | 9B | استنتاج قوي ومهام متعددة اللغات | حوالي 8-10 جيجابايت (4-bit) | نموذج صغير لكنه متوازن وجاد مناسب لأجهزة الكمبيوتر المحمولة. |
| Gemma-style 2B–4B Models | 2B–4B | دردشة، تدوين الملاحظات، مساعدة برمجية بسيطة | حوالي 3-6 جيجابايت (4-bit) | نماذج صغيرة مدعومة من Google تعمل بشكل مريح على الأجهزة الاستهلاكية. |
في جوهرها، فإن نموذج اللغة ما هو إلا كومة ضخمة من الأرقام تسمى الأوزان. تقليديًا، يتم تخزين هذه الأرقام بتنسيقات الفاصلة العائمة 16 أو 32 بت، وهو أمر رائع للدقة ولكنه سيئ لاستخدام الذاكرة. إذا كان كل وزن عبارة عن رقم عالي الدقة ولديك مليارات منها، فسينتهي بك الأمر بملفات نموذجية تزن عدة جيجابايت وتتطلب بصمات VRAM أو RAM ضخمة مماثلة.
تعتمد عملية التكميم على سؤال بسيط: هل تحتاج حقًا إلى هذه الدقة الكبيرة لكل وزن؟ بدلاً من تخزين كل رقم بـ 16 بت، يمكنك تخزينه بـ 8 بت أو حتى 4 بت. هذا وحده يمكن أن يقلص حجم النموذج بمقدار النصف، أو حتى بنسبة 75 بالمائة، مقارنةً بالتنسيقات ذات الدقة الأعلى.
يكمن الجزء الذكي في أن مخططات التكميم الحديثة لا تقوم ببساطة بتقريب كل شيء بغباء؛ بل إنها تجمع بين الحيل مثل الدقة المختلطة، والتحجيم لكل قناة، والمعايرة الدقيقة حتى يحتفظ النموذج بمعظم سلوكه الأصلي. في الاختبارات المعيارية والتقييمات، غالبًا ما تظل المتغيرات ذات 4 بت و 8 بت جيدة الضبط قريبة بشكل مدهش من أصولها كاملة الدقة، بينما تكون أخف وزنًا بشكل كبير عند التشغيل.
من الناحية العملية، هذا يعني أن النموذج الكمي الخاص بك لا يزال يكتب تعليقات برمجية جيدة، ويشرح المفاهيم، ويصوغ رسائل البريد الإلكتروني بشكل جيد، ولكنه الآن يتناسب بشكل مريح مع القرص والذاكرة. بدلاً من الحاجة إلى وحدة معالجة رسومات متطورة مع VRAM ضخم، يمكن أن يستقر في ذاكرة النظام على سطح مكتب أو كمبيوتر محمول نموذجي والاستجابة بسرعات تفاعلية.
نعم، يمكنك تشغيل هذه النماذج على وحدة المعالجة المركزية CPU
وحدة معالجة الرسومات GPU أمر جيد، ولكنها ليست شرطًا أساسيًا
إذا كانت توقعاتك معقولة، فلن تحتاج حتى إلى وحدة معالجة رسومات GPU على الإطلاق. مع الجيل الحالي من مكتبات الاستدلال والخلفيات، يمكنك تشغيل النماذج الكمية بشكل كامل على وحدة المعالجة المركزية CPU، طالما لديك معالج حديث متعدد النواة وكمية معقولة من ذاكرة الوصول العشوائي RAM. يكفي وحدة معالجة مركزية CPU لسطح المكتب أو الكمبيوتر المحمول رباعية إلى ثماني النواة مقترنة بذاكرة وصول عشوائي RAM بسعة 16 جيجابايت للبدء بالنماذج الأصغر. تمنحك ذاكرة الوصول العشوائي RAM الأكبر، مثل 32 جيجابايت أو أعلى، مساحة أكبر لتجربة النماذج الأكبر.
تعتمد هذه الأدوات بشكل كبير على التحسينات منخفضة المستوى. فهي تستخدم تعليمات مُوَجَّهة، ورسم خرائط فعالة للذاكرة، وتعدد مؤشرات الترابط لضغط أكبر قدر ممكن من الأداء من وحدة المعالجة المركزية (CPU). والنتيجة هي أن نموذج 4 بت أو 8 بت يمكن أن يكون في نطاق 3B إلى 7B يصبح قابلاً للاستخدام على جهاز نموذجي. لن تتمكن من معالجة مهام دفعية ضخمة، ولكن بالنسبة لنافذة دردشة تفاعلية، أو رفيق كتابة، أو مساعد ترميز، فإن أوقات الاستجابة مقبولة تمامًا دون وجود وحدة معالجة رسومات (GPU) مخصصة في الأفق.
ما هي المهام التي تتفوق فيها النماذج الكمية فعليًا؟
المساعدة في الكتابة والتلخيص والترميز محليًا
إذا كنت معتادًا على النماذج السحابية من فئة GPT-4، فمن العدل أن تتساءل عما يمكن لهذه النماذج الكمية الأصغر حجمًا التعامل معه بشكل واقعي. والإجابة هي: أكثر مما قد تتوقع، خاصة بالنسبة للمهام اليومية المركزة. على جهاز متواضع، يمكن التعامل بسهولة مع أي شيء بدءًا من الكتابة والترميز والاستدلال العام. يمكنه تحديد الخطوط العريضة للمدونات، وصياغة رسائل البريد الإلكتروني، وإعادة كتابة الفقرات غير المتقنة، وتلخيص الملاحظات أو المستندات الطويلة. يمكنه أيضًا إرشادك خلال رسائل الخطأ، واقتراح إعادة هيكلة للوظائف الصغيرة، وإنشاء مقتطفات للنماذج الأولية أو التكوين. مع ظهور طرق مثيرة للاهتمام لاستخدام النماذج اللغوية الكبيرة المحلية (LLMs) مع أدوات MCP، فإن الاحتمالات لا حدود لها.
تم تصميم النماذج الصغيرة ولكن الذكية الحديثة مثل Llama 3.2 1B و 3B Instruct من Meta، و Phi-3.5 Mini من Microsoft، ومتغيرات Qwen و Gemma المدمجة بشكل صريح للتألق في هذه السيناريوهات. لقد تم تدريبها وضبطها لتكون فعالة، وليس مجرد كبيرة، لذلك فهي تتفوق على وزنها عند تحديد الكمية. لن تستخدمها بالضرورة لإنشاء تقرير بحثي كامل مع اقتباسات مباشرة، ولكن بالنسبة للمهام اليومية وتبادل الأفكار، فإنها تبدو قريبة بشكل مدهش من نظيراتها الأكبر حجمًا.
إذًا، هل ما زلت بحاجة إلى وحدة معالجة رسومات (GPU)؟
متى يكون وجود وحدة معالجة رسومات (GPU) منطقيًا حقًا
إذا كنت تدرب نماذج كبيرة من الصفر، أو تضبط معمارات ضخمة على نطاق واسع، أو تحاول الحصول على كل نقطة قياس أداء أخيرة من نموذج رائد، فنعم، لا تزال وحدة معالجة الرسوميات (GPU) القوية، أو عدة وحدات، مهمة. هذا ما تتفوق فيه وحدات معالجة الرسوميات (GPUs). ولكن إذا كان ما تريده فعليًا هو رفيق كتابة ذكي، أو مساعد ترميز يفهم مشروعك، أو نموذج دردشة خاص لتبادل الأفكار والتخطيط والتعلم، فربما لا تحتاج إلى الاندفاع وشراء أحدث وحدة معالجة رسوميات (GPU) حتى الآن.
سينقلك نموذج كمي مُختار جيدًا يعمل على جهازك الحالي إلى أبعد مما تتوقع. التحول الذهني الحقيقي هو تقبل فكرة أن الذكاء الاصطناعي لا يجب أن يعيش في السحابة أو في رف من وحدات معالجة الرسوميات (GPUs). مع التكميم واختيار النموذج المناسب، يمكن لأي جهاز حديث نسبيًا تشغيل نماذج الذكاء الاصطناعي محليًا بوتيرة معقولة.